OpenAI DevDay Öncesi Claude Sonnet 5.5, Opus Performansına Yaklaşıyor
Özet
Anthropic, 28 Eylül'de piyasaya sürdüğü Claude Sonnet 5.5 ile yüksek performanslı yapay zeka dünyasında rekabeti kızıştırıyor. Yapılan testler, yeni modelin performans açısından Opus 5.5'e oldukça yakın sonuçlar verirken, özellikle kodlama ve ofis görevlerinde güçlü bir grafik çizdiğini gösteriyor. Sonnet 5.5, Opus modeline kıyasla yarı yarıya daha düşük maliyet ve daha yüksek işlem hızı sunarak kullanıcılar için ekonomik bir alternatif oluşturuyor. OpenAI'ın DevDay etkinliği öncesinde gerçekleşen bu lansman, Anthropic'in hem performans hem de maliyet verimliliğinde önemli bir avantaj elde ettiğini kanıtlıyor.
Anthropic, 28 Eylül'de Claude Sonnet 5.5'i piyasaya sürdü. The Rundown'ın bildirdiğine göre model, çeşitli testlerde Opus 5.5'e oldukça yakın performans gösterirken, giriş ve çıkış token maliyetlerinde Opus'un yarı fiyatına sunuluyor.
Bu lansman, bugün gerçekleşecek ve açılış konuşmasının Pasifik saatiyle 10:00'da başlayacağı DevDay öncesinde OpenAI üzerinde baskı oluşturuyor.
Testler ne gösteriyor?
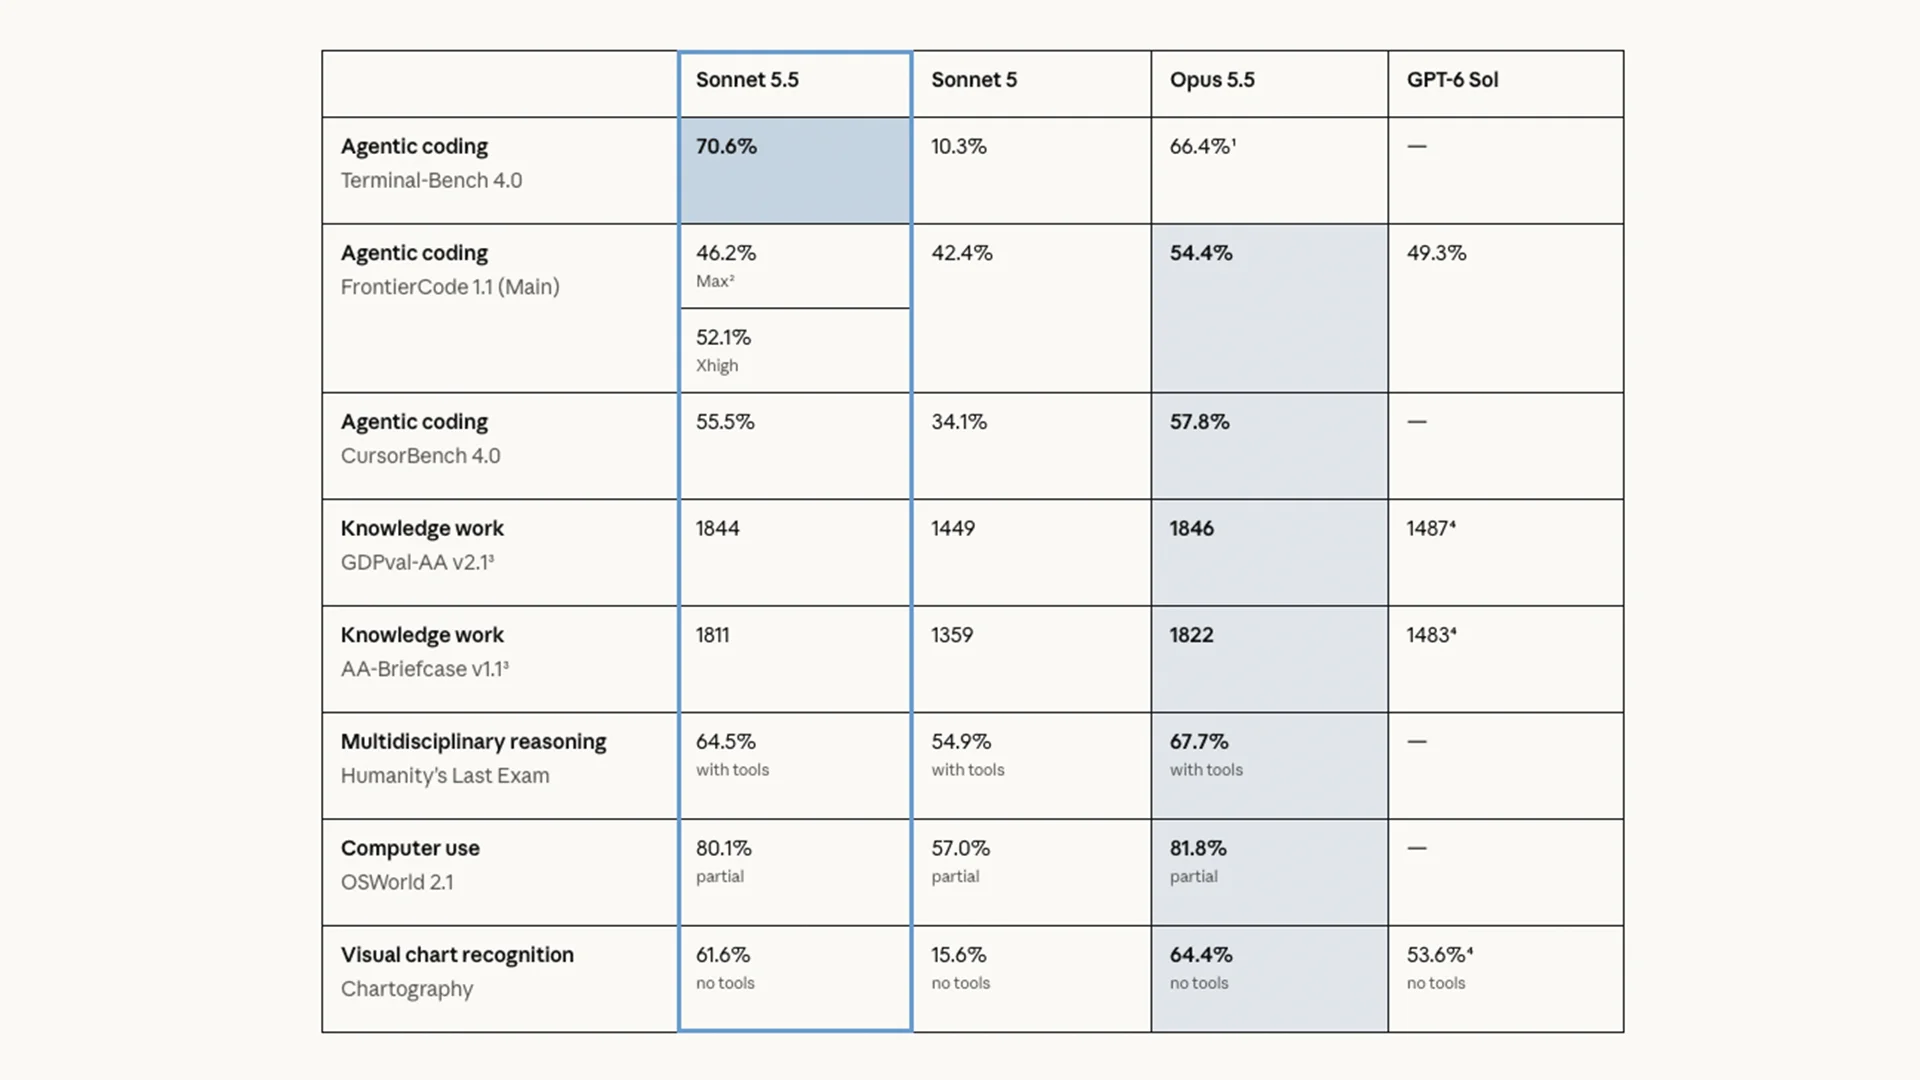
Maksimum performans düzeyinde Artificial Analysis, Sonnet 5.5'e Intelligence Index'te 56 puan verirken, onu sadece 58 puan alan Opus 5.5'in gerisinde bıraktı. Ofis performansındaki sonuçlar da benzer şekilde birbirine çok yakındı. Sonnet, GDPval-AA ve AA-Briefcase testlerinde Opus ile neredeyse başa baş giderken; AutomationBench-AA testinde Opus'un %70'lik skoruna karşı %71 skor elde etti.
Bir kodlama değerlendirmesi olan Terminal-Bench 4.0'ta ise AA, Sonnet için %64 ölçerken, hem Opus hem de GPT-6 Astra için yaklaşık %60 ölçtü.
Bu sonuçlar henüz kesin değil. AA, yapılandırılmış çıktı hatasından etkilenen bir ön sürüm testini gerçekleştirmiş ve testleri tekrarlamayı planladıklarını belirtmiş.
Token fiyatları ve görev maliyetleri
Anthropic, Sonnet modelini milyon giriş tokeni için 2$, milyon çıkış tokeni için 10$ olarak fiyatlandırırken; Opus için bu fiyatlar sırasıyla 4$ ve 20$ olarak belirlenmiş. Şirket ayrıca, çıkış hızının Sonnet 5'ten en az %30 daha hızlı olduğunu ve görev maliyetlerinin %30'a kadar daha düşük olabileceğini iddia ediyor.
Düşük veya orta seviye çaba gerektiren işlemlerde Anthropic, seçilmiş bazı testlerde Sonnet 5'in en iyi sonuçlarının yaklaşık onda bir maliyetle kazandığını raporluyor.
Gerçek faturalar ise bir modelin işi bitirmek için kaç token harcadığına göre değişiyor. Maksimum çaba düzeyinde AA, görev başına yaklaşık 7,60$ ölçtü; bu rakam Sonnet 5'ten yaklaşık %50 daha fazla. AA'nın testleri ve Anthropic'in seçili karşılaştırmaları farklı ayarları ve iş yüklerini kapsıyor.
Neden önemli?
Anthropic ve OpenAI hakkındaki kamuoyu algısı hızla değişebilir. Claude'ın Eylül ayındaki iki lansmanı, halihazırda yüksek beklentilerin olduğu bir DevDay öncesinde Anthropic için önemli bir başarı gibi görünüyor.
Opus 5.5, 22 Eylül'de giriş ve çıkış token fiyatlarında %20'lik bir indirimle piyasaya sürüldü. Artificial Analysis bu modeli, Intelligence Index testlerinin on tanesinden altısında liderlik ederek birinci sıraya yerleştirdi. Sonnet ise şimdi birkaç testte benzer sonuçları çok daha düşük token fiyatlı bir modelle sunuyor.
Kodlama araçları veya ofis otomasyonu geliştiren yazılımcılar için bu durum; Sonnet'in hata düzeltme ve belge üretimi gibi görevlerde test edilmeye değer olduğunu gösteriyor. Bu tercih, daha hızlı yanıtlar ve daha düşük maliyetler sağlayabilir. Anthropic, yargı ve muhakeme gerektiren karmaşık işlerde Opus'un hala avantajlı olduğunu belirtiyor; bu nedenle ekiplerin belirsiz görevler için hala amiral gemisi modeli değerlendirme gerekçesi var.
Çaba ayarları, satın alma kararının bir parçası haline geliyor. Ekipler, maliyet tasarrufu öngörüsünde bulunmadan önce farklı ayarlarda başarılı tamamlama oranlarını, bitiş süresini, faturalandırılan token sayısını, denemeleri ve insan incelemesi gibi kriterleri karşılaştırmalıdır. Ekstra denemeler veya inceleme süreçleri, düşük token maliyetlerinden elde edilen avantajı sıfırlayabilir.
Anthropic, Sonnet'in yeni siber güvenlik önlemlerinin yüksek riskli olarak değerlendirilen istekleri Sonnet 5'e yönlendirebileceğini belirtiyor. Güvenlik çalışmaları yürüten ekiplerin, bu geri dönüşlerin uygulamalarının sonuçlarını ve davranışlarını nasıl etkilediğini kontrol etmeleri gerekiyor.
OpenAI artık yetenek, yararlı iş ve görev bitirme maliyeti açısından daha güçlü bir kıyaslamayla karşı karşıya. DevDay duyuruları ve AA'nın planladığı yeniden testler bu karşılaştırmayı tekrar değiştirebilir.
Yorumlar
Yorum için giriş yap veya kaydol.
Henüz yorum yok — ilk sen yaz.